立即注册,突破游客限制,与技术大牛交流切磋,畅享海量资源,让你的技术之路不再孤单!
您需要 登录 才可以下载或查看,没有账号?立即注册
×
基于angr和idapython的非标准OLLVM-fla反混淆分析还原 序言本文章主要是采用angr框架和idapython脚本相结合,实现对非标准ollvm-fla控制流平坦化反混淆的分析和处理,以及对angr和idapython相关api进项讲解。 为什么要用angr解决fla要解决fla的混淆,需要实现三大步骤: - 找到函数的所有真实块
- 找到真实块之间的连接关系
- 重建真实块之间的控制流
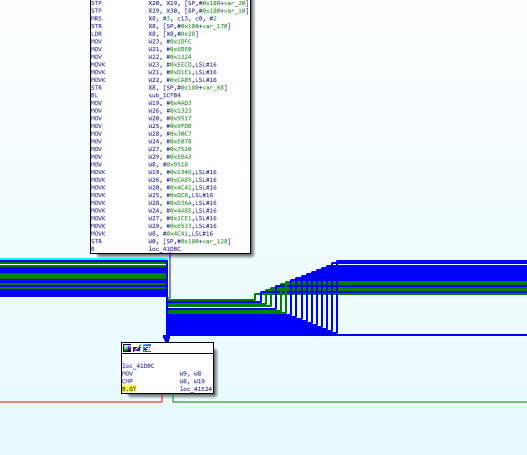
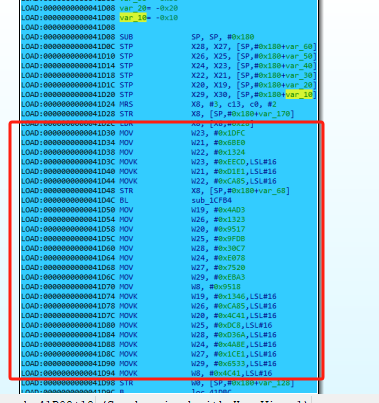
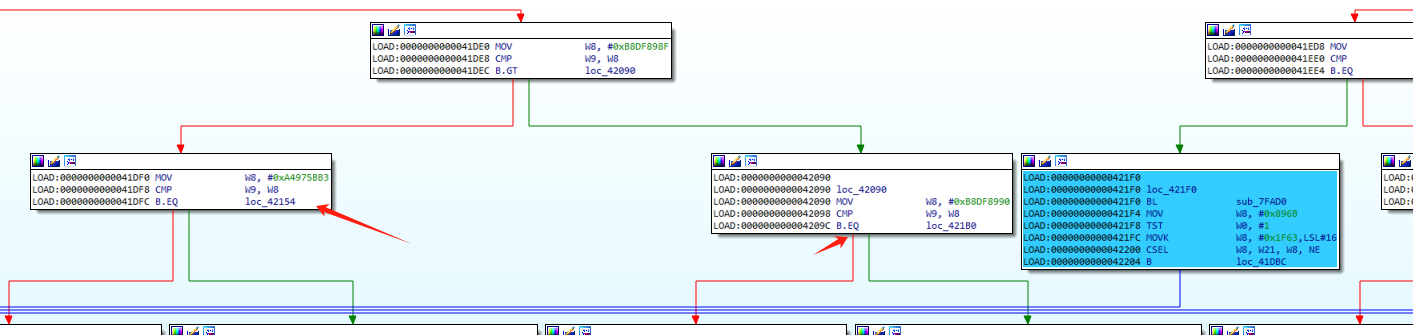
步骤1,3相对简单,这里可以看大家的喜好,愿意用angr也是可以的,我倾向于在分析fla混淆的时候能够实时的观测到修改块的实时现象,我就采用了idapython脚本处理。 这里主要说的是步骤2,比如,当我们拿到了所有真实块,我们应该怎么去找到真是块之间的连接关系。遇到混淆程度不高的,可以尝试体力活修改。那么遇到下面的这种混淆,请问阁下该如何应对。 所以,这里我们需要用到angr的一个强大功能:符号执行(angr更多的原理需自行百度查阅) 这里又衍生出一个新问题,什么是符号执行? 它的运行和unidbg类似,都是通过模拟执行,但是不同的是,unidbg的模拟执行需要传入具体的数值,而angr可以不需要。 比如下面一个简单的加法函数,unidbg要模拟执行它,就需要传入a和b具体的数值,假设传入a=1,b=2,这里unidbg的执行结果就是3。 而angr不需要,它执行直接传入符号a和b,注意这里是符号,不是具体的值,最后通过模拟执行,输出结果a+b。
- int add(int a ,int b){
- return a+b;
- }
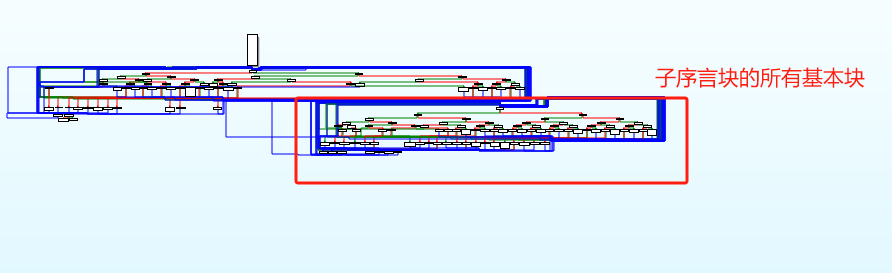
所以我们就是利用angr符号执行的特性,用到其中主要的路径探索的能力,当执行到第一个真实块A的时候 ,把它标记为主块,然后让其继续运行,当它碰到的第一个真实块B的时候,这里就是A的后继块,那么A和B的连接关系就被我们给找到了。这里也要注意到angr的一个路径爆炸的问题,后面会说怎么去规避。 反混淆此函数作为本章内容的分析目标,这是一个非标准的ollvm,其有两个循环头 找真实块反混淆的第一步,找到函数的所有真实块。用idapython脚本处理 获取函数的所有基本块
- blocks = idaapi.FlowChart(idaapi.get_func(func_ea))
获取函数的所有循环头通过循环头我们可以直接获取到所有对应的真实块 采用广度搜索的原理实现循环头的获取 - def find_loop_heads(func):
- loop_heads = set()
- queue = deque()
- block = get_block_by_address(func)
- queue.append((block, []))
- while len(queue) > 0:
- cur_block, path = queue.popleft()
- if cur_block.start_ea in path:
- loop_heads.add(cur_block.start_ea)
- continue
- path = path+ [cur_block.start_ea]
- queue.extend((succ, path) for succ in cur_block.succs())
- all_loop_heads = list(loop_heads)
- all_loop_heads.sort()#升序排序,保证函数开始的主循环头在第一个
- return all_loop_heads
获取汇聚块这里要处理标准fla和非标准fla的获取方式 非标准fla的循环头地址和汇聚块的地址是相等的 标准fla的循环头地址和汇聚块的地址是不相等的,其循环头的前驱只有两个基本块,一个是序言块,一个是汇聚块。 - def find_converge_addr(loop_head_addr):
- converge_addr = None
- block = get_block_by_address(loop_head_addr)
- preds = block.preds()
- pred_list = list(preds)
- if len(pred_list) == 2:#循环头的前驱有两个基本块,这种一般是标准ollvm
- for pred in pred_list:
- tmp_list = list(pred.preds())
- if len(tmp_list) >1:#
- converge_addr = pred.start_ea
- else:#非标准ollvm
- converge_addr= loop_head_addr
- return converge_addr
得到所有真实块有了汇聚块,就可以通过block所属的preds()方法获得所有的前驱块,也就是它的真实块。标准fla还得注意循环头的前驱块中,需要保留序言块 - real_blocks = []
-
- if loop_head_addr != converge_addr:
- loop_head_preds_addr.remove(converge_addr)#移除汇聚块,剩下的一个是序言块
- real_blocks.extend(loop_head_preds_addr)
-
- converge_block = get_block_by_address(converge_addr)
- list_preds = list(converge_block.preds())
- for pred_block in list_preds:
- if pred_block.start_ea == loop_head_addr:#过滤循环头
- continue
- end_ea = pred_block.end_ea
- last_ins_ea = idc.prev_head(end_ea)
- mnem = idc.print_insn_mnem(last_ins_ea) # 获取基本块最后一条指令的操作符
-
- size = get_basic_block_size(pred_block)
- if size > 4 and "B." not in mnem:
- start_ea = pred_block.start_ea
- mnem = idc.print_insn_mnem(start_ea)
- if mnem == "CSEL":
- csel_preds = pred_block.preds()
- for csel_pred in csel_preds:
- real_blocks.append(csel_pred.start_ea)
- else:
- real_blocks.append(pred_block.start_ea)
- start_ea = pred_block.start_ea
- mnem = idc.print_insn_mnem(start_ea)
- if mnem == "CSEL":
- csel_preds = pred_block.preds()
- for csel_pred in csel_preds:
- real_blocks.append(csel_pred.start_ea)
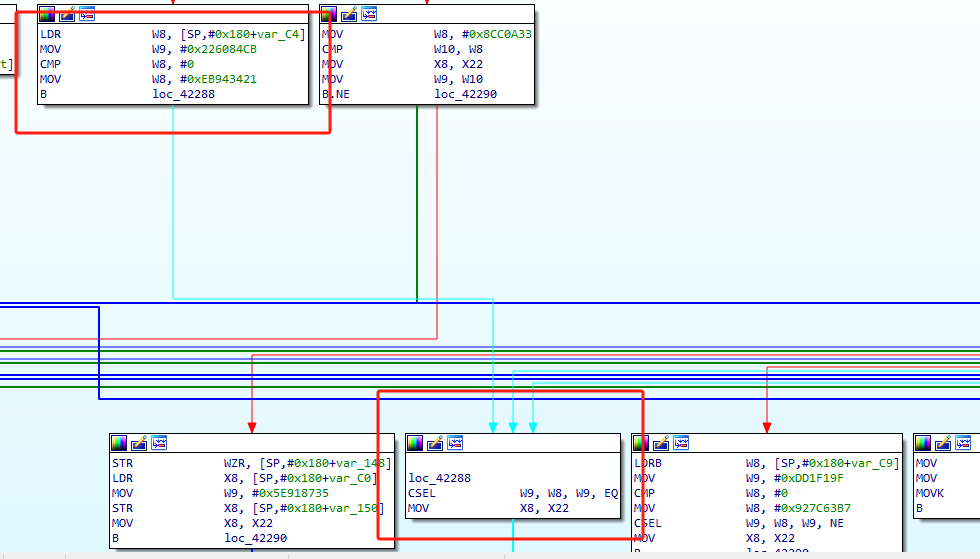
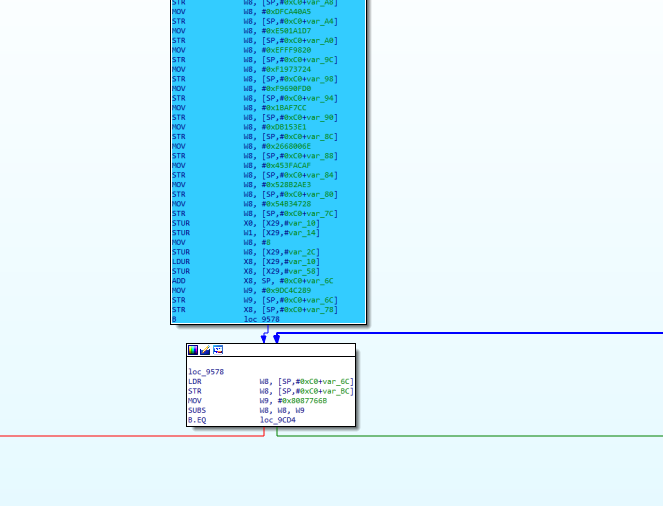
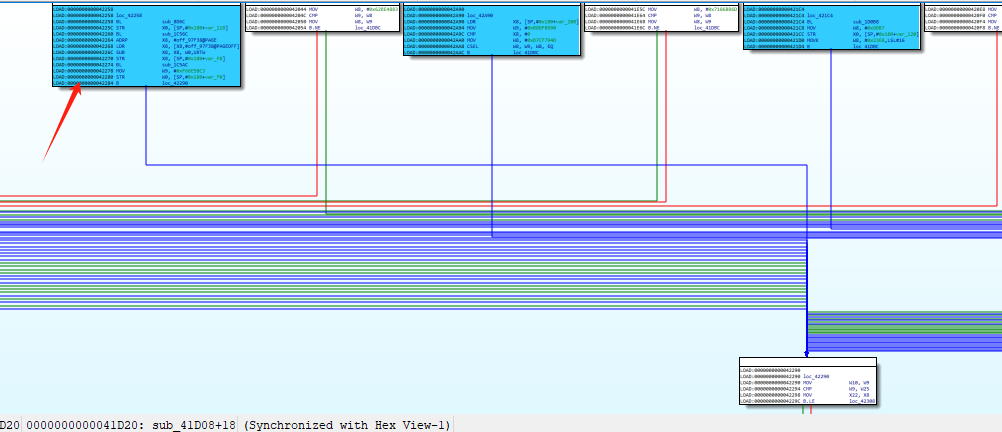
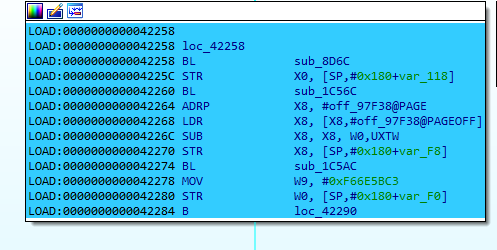
这个真实块的获取也需要注意,有的会出现多个基本块的尾部指令是相同的,ida会把它单独提取出来共享,如果我们直接使用0x42288的基本块作为真实块,会出现真实块遗漏,导致反混淆的代码不全。所以这里需要取0x42288的所有前驱作为真实块。
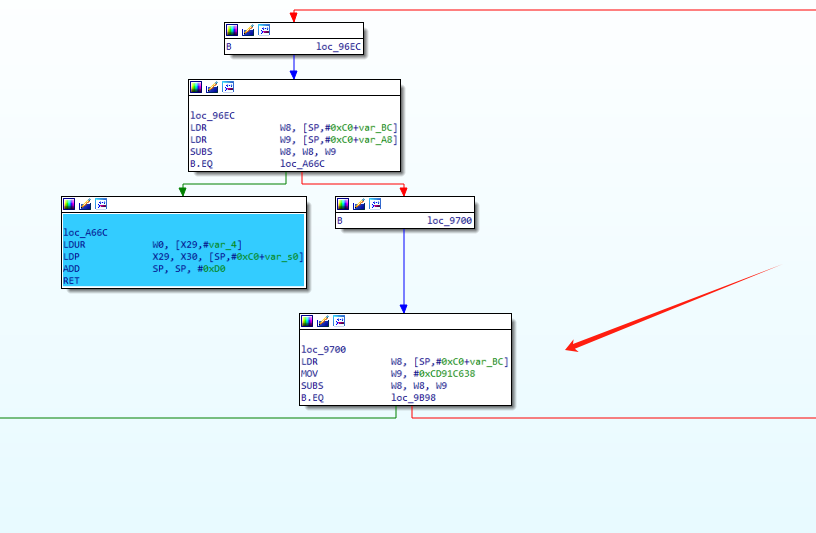
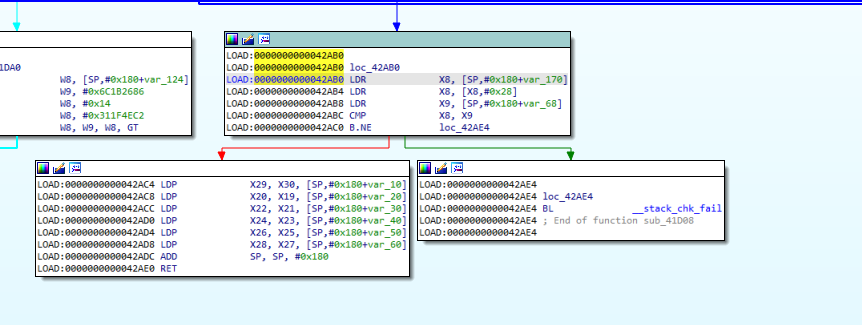
ret块的获取 像标准fla,我们就需要0xA66C作为ret块 非标准fla,我们就需要0x42AB0作为ret块,为什么不选择0x42AC4为ret块呢?有两个原因:1.0x42AB0块中出有变量初始化的指令,如果直接选择0x42AC4,会导致反汇编后的真实代码遗漏。2.0x42AE4这条分支也没有后继。 从这里也可以引申出为社么标准fla要选择0xA66C作为ret块,如果选择0x96EC,因为0x9700分支有后继,还是会存在混淆代码,导致反混淆无效,虽然去除了一部分,但是还是无法直观分析代码。 完整代码
- from collections import deque
- import idaapi
- import idc
-
- def get_block_by_address(ea):
- # 获取地址所在的函数
- func = idaapi.get_func(ea)
- blocks = idaapi.FlowChart(func)
- for block in blocks:
- if block.start_ea <= ea < block.end_ea:
- return block
- return None
-
- def find_loop_heads(func):
- loop_heads = set()
- queue = deque()
- block = get_block_by_address(func)
- queue.append((block, []))
- while len(queue) > 0:
- cur_block, path = queue.popleft()
- if cur_block.start_ea in path:
- loop_heads.add(cur_block.start_ea)
- continue
- path = path+ [cur_block.start_ea]
- queue.extend((succ, path) for succ in cur_block.succs())
- all_loop_heads = list(loop_heads)
- all_loop_heads.sort()#升序排序,保证函数开始的主循环头在第一个
- return all_loop_heads
-
- def find_converge_addr(loop_head_addr):
- converge_addr = None
- block = get_block_by_address(loop_head_addr)
- preds = block.preds()
- pred_list = list(preds)
- if len(pred_list) == 2:#循环头的前驱有两个基本块,这种一般是标准ollvm
- for pred in pred_list:
- tmp_list = list(pred.preds())
- if len(tmp_list) >1:#
- converge_addr = pred.start_ea
- else:#非标准ollvm
- converge_addr= loop_head_addr
- return converge_addr
-
- def get_basic_block_size(bb):
- return bb.end_ea - bb.start_ea
-
- def add_block_color(ea):
- block = get_block_by_address(ea)
- curr_addr = block.start_ea
- while curr_addr <block.end_ea:
- idc.set_color(curr_addr,idc.CIC_ITEM,0xffcc33)
- curr_addr = idc.next_head(curr_addr)
-
- #清除函数中的颜色渲染
- def del_func_color(curr_addr):
- end_ea = idc.find_func_end(curr_addr)
- while curr_addr < end_ea:
- idc.set_color(curr_addr, idc.CIC_ITEM, 0xffffffff)
- curr_addr = idc.next_head(curr_addr)
-
- def find_ret_block_addr(blocks):
- for block in blocks:
- succs = block.succs() # 获取后继块
- succs_list = list(succs) # 转为list结构
-
- end_ea = block.end_ea
- last_ins_ea = idc.prev_head(end_ea)
- mnem = idc.print_insn_mnem(last_ins_ea)
-
- if len(succs_list) == 0:
- if mnem == "RET":
- # 如果直接去把RET指令所在的块作为返回块的表示 最后可能会出现反混淆代码赋值错误
- # 所以这里取RET指令的前驱块并且前驱块的大小不能只有一条指令,一般这个块都是有分支的
- ori_ret_block = block
- while True:
- tmp_block = block.preds()
- pred_list = list(tmp_block)
- if len(pred_list) == 1:
- block = pred_list[0]
- if get_basic_block_size(block) == 4:
- continue
- else:
- break
- else:
- break
-
- # 此处while循环是为了解决当上述的ret块作为子分发器时,需要重新更改ret块为带ret指令的块
- block2 = block
- num = 0
- i = 0
- while True:
- i += 1
- succs_block = block2.succs()
- for succ in succs_block:
- child_succs = succ.succs()
- succ_list = list(child_succs)
- if len(succ_list) != 0:
- block2 = succ
- num += 1
- if num > 2:
- block = ori_ret_block
- break
- if i > 2:
- break
- return block.start_ea
-
- def find_all_real_block(func_ea):
-
- blocks = idaapi.FlowChart(idaapi.get_func(func_ea))
-
- loop_heads = find_loop_heads(func_ea)#获取所有循环头 非标准ollvm出现在多个主分发器
- print(f"循环头数量:{len(loop_heads)}----{[hex(loop_head) for loop_head in loop_heads]}")
-
- all_real_block=[]
- for loop_head_addr in loop_heads:
- loop_head_block = get_block_by_address(loop_head_addr)#获取循环头
- loop_head_preds = list(loop_head_block.preds())#获取循环头的所有前驱块
- loop_head_preds_addr = [loop_head_pred.start_ea for loop_head_pred in loop_head_preds]#把所有前驱块转为数组
-
- converge_addr = find_converge_addr(loop_head_addr)#获取汇聚块地址
-
- real_blocks = []
-
- if loop_head_addr != converge_addr:
- loop_head_preds_addr.remove(converge_addr)#移除汇聚块,剩下的一个是序言块
- real_blocks.extend(loop_head_preds_addr)
-
- converge_block = get_block_by_address(converge_addr)
- list_preds = list(converge_block.preds())
- for pred_block in list_preds:
- end_ea = pred_block.end_ea
- last_ins_ea = idc.prev_head(end_ea)
- mnem = idc.print_insn_mnem(last_ins_ea) # 获取基本块最后一条指令的操作符
-
- size = get_basic_block_size(pred_block)
- if size > 4 and "B." not in mnem:
- start_ea = pred_block.start_ea
- mnem = idc.print_insn_mnem(start_ea)
- if mnem == "CSEL":
- csel_preds = pred_block.preds()
- for csel_pred in csel_preds:
- real_blocks.append(csel_pred.start_ea)
- else:
- real_blocks.append(pred_block.start_ea)
-
- real_blocks.sort()#排序后第一个元素始终序言块
- all_real_block.append(real_blocks)
- print("子循环头:", [hex(child_block_ea) for child_block_ea in real_blocks])
-
- #获取return块
- ret_addr = find_ret_block_addr(blocks)
- all_real_block.append(ret_addr)
- print("all_real_block:",all_real_block)
-
- all_real_block_list = []
- for real_blocks in all_real_block:
- if isinstance(real_blocks, list): # 如果是列表,用 extend
- all_real_block_list.extend(real_blocks)
- else: # 如果不是列表,用 append
- all_real_block_list.append(real_blocks)
-
- for real_block_ea in all_real_block_list:
- # idc.add_bpt(real_block_ea)#断点
- add_block_color(real_block_ea)#渲染颜色
-
- print("\n所有真实块获取完成")
- print("===========INT===============")
- print(all_real_block_list)
- print("===========HEX===============")
- print(f"数量:{len(all_real_block_list)}")
- print([hex(real_block_ea) for real_block_ea in all_real_block_list],"\n")
-
- #移除ret地址和主序言块相关真实块,保留子序言块相关的真实块
- all_child_prologue_addr = all_real_block.copy()
- all_child_prologue_addr.remove(ret_addr)
- all_child_prologue_addr.remove(all_child_prologue_addr[0])
- print("所有子序言块相关的真实块地址:",all_child_prologue_addr)
-
- all_child_prologue_last_ins_ea = []
- for child_prologue_array in all_child_prologue_addr:
- child_prologue_addr = child_prologue_array[0]
- child_prologue_block = get_block_by_address(child_prologue_addr)
- child_prologue_end_ea = child_prologue_block.end_ea
- child_prologue_last_ins_ea = idc.prev_head(child_prologue_end_ea)
- all_child_prologue_last_ins_ea.append(child_prologue_last_ins_ea)
- # print("所有子序言块的最后一条指令的地址:", [hex(ea) for ea in all_child_prologue_last_ins_ea])
- print("所有子序言块的最后一条指令的地址:", all_child_prologue_last_ins_ea)
- return all_real_block,all_child_prologue_addr,all_child_prologue_last_ins_ea
-
- func_ea = 0x41D08
- reals = find_all_real_block(func_ea)
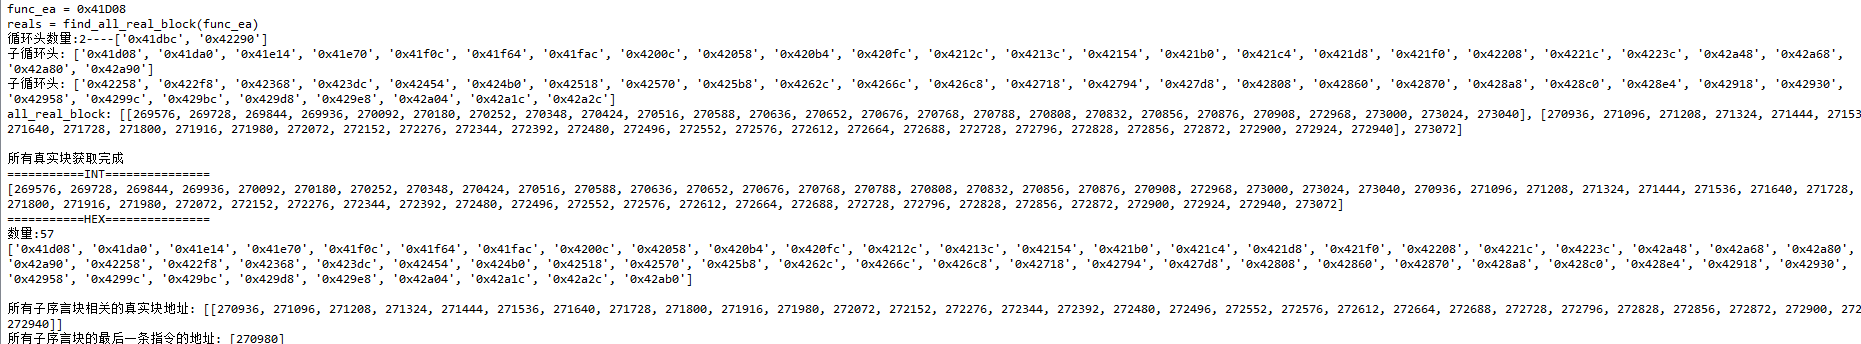
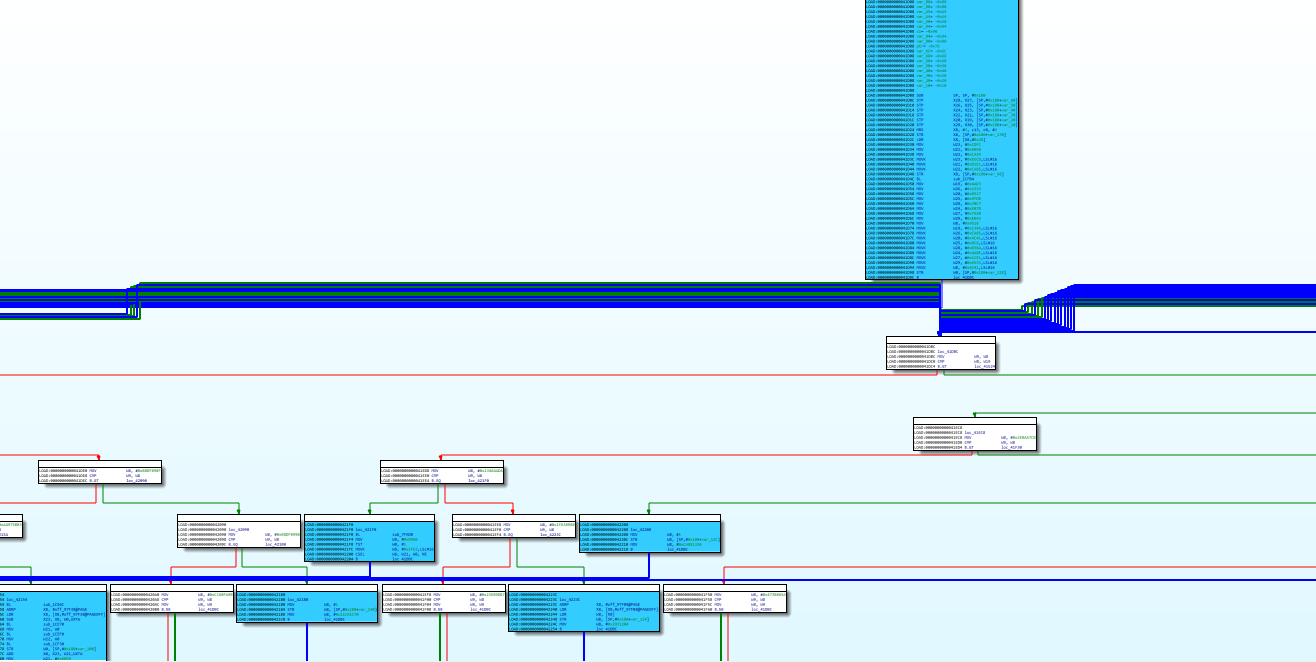
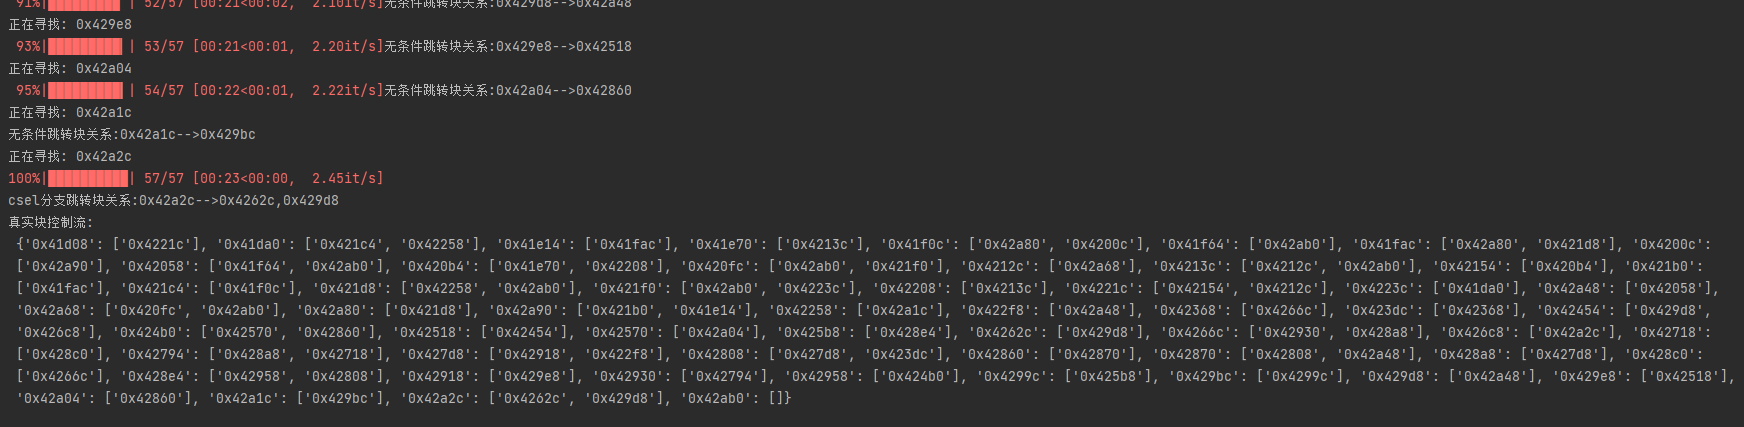
用后,通过颜色标记了所有的真实块 找真实块连接关系反混淆的第二步,找到函数的所有真实块连接关系。用angr处理 这里就解决前面说到的在探索路径时遇到的路径爆炸的问题,一般常出现在一个循环里带一个if条件判断,这个时候angr就会由一条路径分裂出两条路径,这两条路径分别是if为true时的路径,和为false的路径,然后继续执行循环循环,此时2条路径就会变成4条路径,继续循环,4条路径就会出现8条路径......所以遇到这种情况,路径会以指数的形式增加,最后路径会膨胀到非常大,导致程序卡死。 real_blocks是我上面获取到的所有真实块 所以接下来我采用的方式是,不让它整个程序一次性执行完,而是每次取一个真实块地址real_blocks[0],作为主块A,让其运行,当再次遇到的一个B地址在我保存的真实块地址里时我就停止运行,把这个块连接A->B保存下来。然后再取real_blocks[1]为主块,从头开始继续运行,再次遇到的一个地址在真实块地址里就停止运行。重复这个操作,我也就不用担心路径爆炸的问题,并且也会获得所有真实块的连接关系。 angr基本模板
- proj = angr.Project(file_path, auto_load_libs=False)#加载so
- base = proj.loader.min_addr#so基地址
- func_addr = base + func_offset#函数地址
- init_state = proj.factory.blank_state(addr=func_addr)#获取函数地址状态
- init_state.options.add(angr.options.CALLLESS)
在一般情况下,加载程序都会将 auto_load_libs 置为 False ,这是因为如果将外部库一并加载,那么 Angr 就也会跟着一起去分析那些库了,这对性能的消耗是比较大的。 - blank_state:构造一个“空白板”空白状态,其中大部分数据未初始化。当访问未初始化的数据时,将返回一个不受约束的符号值。
- entry_state:造一个准备在主二进制文件的入口点执行的状态。
- full_init_state:构造一个准备好通过任何需要在主二进制文件入口点之前运行的初始化程序执行的状态,例如,共享库构造函数或预初始化程序。完成这些后,它将跳转到入口点。
- call_state:构造一个准备好执行给定函数的状态。
执行流程构建在序言块里会有许多寄存器的赋值操作,这些都是一些基本块的条件判断,通过寄存器值判断应该走哪条路径 典型的就是以基本块最后一条指令的B.EQ,B.GT等等作为判断,这些都是子分发器。 通过hook操作,当程序执行到主序言块的最后一条指令时,将pc寄存器赋值为真实块的值,这样可以避免执行大量的无用指令,减少性能消耗,节约更多的时间。 这里主要处理主序言块所有的真实块的操作,相关流程: 复制代码
- def jump_to_address(state):
- state.regs.pc = base + real_block_addr - 4
-
- if prologue_block_addr == 0:
- #当序言块执行完后(初始化后续条件判断的寄存器),将最后一条指令的pc寄存器指向真实块地址
- if real_block_addr != func_offset:
- proj.hook(first_block_last_ins.address, jump_to_address, first_block_last_ins.size)
这个是第二个循环头的序言块,后面就叫它子序言块 - def jump_to_child_prologue_address(state):
- state.regs.pc = prologue_block_addr - 4
- else:
- proj.hook(first_block_last_ins.address, jump_to_child_prologue_address, first_block_last_ins.size)
- proj.hook(child_prologue_last_ins_ea, jump_to_address, 4)
这里也是一样用hook操作,改变pc寄存器的值。但是这里多了一步hook,多的 proj.hook(first_block_last_ins.address, jump_to_child_prologue_address, first_block_last_ins.size)这个hook是为了初始化子序言块里的寄存器值,因为子序言块0x42258里也有一些条件判断的寄存器赋值操作。 所以这里的流程是: - 主序言块 --> 子序言块 --> 主块 -->后继块
完整代码构建流程分析完了,这里就直接贴上相关脚本,脚本里也注释了相关代码的作用 - import logging
- import time
-
- import angr
- from tqdm import tqdm
-
- logging.getLogger('angr').setLevel(logging.ERROR)#过滤angr日志,只显示ERROR日志,里面许多的WARNING输出影响日志分析
-
- def capstone_decode_csel(insn):
- operands = insn.op_str.replace(' ', '').split(',')
- dst_reg = operands[0]
- condition = operands[3]
- reg1 = operands[1]
- reg2 = operands[2]
- return dst_reg,reg1, reg2,condition
-
- def print_reg(state,reg_name):
- value = state.regs.get(reg_name)
- print(f"地址:{hex(state.addr)},寄存器:{reg_name},value:{value}")
-
- def find_state_succ(proj,base,local_state,flag,real_blocks,real_block_addr,path):
- ins = local_state.block().capstone.insns[0]
- dst_reg, reg1, reg2,condition = capstone_decode_csel(ins)
- val1 = local_state.regs.get(reg1)
- val2 = local_state.regs.get(reg2)
- # print(f"寄存器值 {reg1}:{val1},{reg2}:{val2}")
-
- sm = proj.factory.simgr(local_state)
- sm.step(num_inst=1)
- tmp_state = sm.active[0]
- if flag:
- setattr(tmp_state.regs, dst_reg, val1) # 给寄存器的条件判断结果设为真
- else:
- setattr(tmp_state.regs, dst_reg, val2) # 给寄存器的条件判断结果设为假
-
- # print(f"开始运行的寄存器:{sm.active[0].regs.get(dst_reg)}")
- while len(sm.active):
- # print(sm.active)
- for active_state in sm.active:
- ins_offset = active_state.addr - base
- # if ins_offset == 0x41DC0:
- # print_reg("x8")
- if ins_offset in real_blocks:
- value = path[real_block_addr]
- if ins_offset not in value:#如果当前后继块不在path里,则添加,否则继续循环寻找
- value.append(ins_offset)
- return ins_offset
- sm.step(num_inst=1)
-
- def find_block_succ(proj,base,func_offset,state, real_block_addr, real_blocks, path):
- msm = proj.factory.simgr(state) #构造模拟器
-
- # 第一个while的作用:寻找到传入的真实块地址作为主块,再复制一份当前state,准备后继块获取的操作
- while len(msm.active):
- # print(f"路径{msm.active}")
- for active_state in msm.active:
- offset = active_state.addr - base
- if offset == real_block_addr: # 找到真实块
- mstate = active_state.copy() #复制state,为后继块的获取做准备
- msm2 = proj.factory.simgr(mstate)
- msm2.step(num_inst=1) # 防止下个while里获取后继块的时候key和value重复
- #第二个while的作用:寻找真实块的所有后继块
- while len(msm2.active):
- # print(msm2.active)
- for mactive_state in msm2.active:
- ins_offset = mactive_state.addr - base
- if ins_offset in real_blocks:#无分支块
- #在无条件跳转中,并且有至少两条路径同时执行到真实块时,取非ret块的真实块
- msm2_len = len(msm2.active)
- if msm2_len > 1:
- tmp_addrs = []
- for s in msm2.active:
- moffset = s.addr-base
- tmp_value = path[real_block_addr]
- if moffset in real_blocks and moffset not in tmp_value:
- tmp_addrs.append(moffset)
- if len(tmp_addrs) > 1:
- print("当前至少有两个路径同时执行到真实块:",[hex(tmp_addr) for tmp_addr in tmp_addrs])
- ret_addr = real_blocks[len(real_blocks)-1]
- if ret_addr in tmp_addrs:
- tmp_addrs.remove(ret_addr)
- ins_offset = tmp_addrs[0]
- print("两个路径同时执行到真实块最后取得:",hex(ins_offset))
-
- value = path[real_block_addr]
- if ins_offset not in value:
- value.append(ins_offset)
- print(f"无条件跳转块关系:{hex(real_block_addr)}-->{hex(ins_offset)}")
- return
-
- ins = mactive_state.block().capstone.insns[0]
- if ins.mnemonic == 'csel':#有分支块
- state_true = mactive_state.copy()
- state_true_succ_addr = find_state_succ(proj,base,state_true, True, real_blocks,real_block_addr, path)
-
- state_false = mactive_state.copy()
- state_false_succ_addr = find_state_succ(proj,base,state_false, False, real_blocks,real_block_addr, path)
-
- if state_true_succ_addr is None or state_false_succ_addr is None:
- print("csel错误指令地址:",hex(ins_offset))
- # print(f"csel后继有误:{hex(real_block_addr)}-->{state_true_succ_addr},{state_false_succ_addr}")
- print(f"csel后继有误:{hex(real_block_addr)}-->{hex(state_true_succ_addr) if state_true_succ_addr is not None else state_true_succ_addr},"
- f"{hex(state_false_succ_addr) if state_false_succ_addr is not None else state_false_succ_addr}")
- return "erro"
-
- print(f"csel分支跳转块关系:{hex(real_block_addr)}-->{hex(state_true_succ_addr)},{hex(state_false_succ_addr)}")
- return
- msm2.step(num_inst=1)
- return # 真实块集合中的最后一个基本块如果最后没找到后继,说明是return块,直接返回
- msm.step(num_inst=1)
-
- def angr_main(real_blocks,all_child_prologue_addr,all_child_prologue_last_ins_ea,func_offset,file_path):
- proj = angr.Project(file_path, auto_load_libs=False)
- base = proj.loader.min_addr
- func_addr = base + func_offset
- init_state = proj.factory.blank_state(addr=func_addr)
- init_state.options.add(angr.options.CALLLESS)
-
- path = {key: [] for key in real_blocks} # 初始化所有键的值为空列表
- ret_addr = real_blocks[len(real_blocks) - 1]
-
- first_block = proj.factory.block(func_addr)
- first_block_insns = first_block.capstone.insns
- # 获取主序言块的最后一条指令
- first_block_last_ins = first_block_insns[len(first_block_insns) - 1]
-
- for real_block_addr in tqdm(real_blocks):
- if ret_addr == real_block_addr:
- continue
-
- prologue_block_addr = 0
- child_prologue_last_ins_ea = 0
- if len(all_child_prologue_addr)>0:
- for index,child_prologue_array in enumerate(all_child_prologue_addr):
- if real_block_addr in child_prologue_array:
- prologue_block_addr = child_prologue_array[0]+base
- child_prologue_last_ins_ea = all_child_prologue_last_ins_ea[index]
-
- state = init_state.copy()#拷贝初始化state,独立state
- print("正在寻找:",hex(real_block_addr))
-
- def jump_to_address(state):
- state.regs.pc = base + real_block_addr - 4
-
- def jump_to_child_prologue_address(state):
- state.regs.pc = prologue_block_addr - 4
-
- if prologue_block_addr == 0:
- #当序言块执行完后(初始化后续条件判断的寄存器),将最后一条指令的pc寄存器指向真实块地址
- if real_block_addr != func_offset:
- proj.hook(first_block_last_ins.address, jump_to_address, first_block_last_ins.size)
- else:
- proj.hook(first_block_last_ins.address, jump_to_child_prologue_address, first_block_last_ins.size)
- proj.hook(child_prologue_last_ins_ea, jump_to_address, 4)
-
- ret = find_block_succ(proj,base,func_offset,state, real_block_addr, real_blocks, path)
- if ret == "erro":
- return
-
- hex_dict = {
- hex(key): [hex(value) for value in values]
- for key, values in path.items()
- }
-
- print("真实块控制流:\n",hex_dict)
- # 返回重建的控制流
- return hex_dict
-
-
- all_real_blocks =[269576, 269728, 269844, 269936, 270092, 270180, 270252, 270348, 270424, 270516, 270588, 270636, 270652, 270676, 270768, 270788, 270808, 270832, 270856, 270876, 270908, 272968, 273000, 273024, 273040, 270936, 271096, 271208, 271324, 271444, 271536, 271640, 271728, 271800, 271916, 271980, 272072, 272152, 272276, 272344, 272392, 272480, 272496, 272552, 272576, 272612, 272664, 272688, 272728, 272796, 272828, 272856, 272872, 272900, 272924, 272940, 273072]
- all_child_prologue_addr = [[270936, 271096, 271208, 271324, 271444, 271536, 271640, 271728, 271800, 271916, 271980, 272072, 272152, 272276, 272344, 272392, 272480, 272496, 272552, 272576, 272612, 272664, 272688, 272728, 272796, 272828, 272856, 272872, 272900, 272924, 272940]]
- all_child_prologue_last_ins_ea = [270980]
-
- angr_main(all_real_blocks,all_child_prologue_addr,all_child_prologue_last_ins_ea,0x41D08,"libgeiri.so")
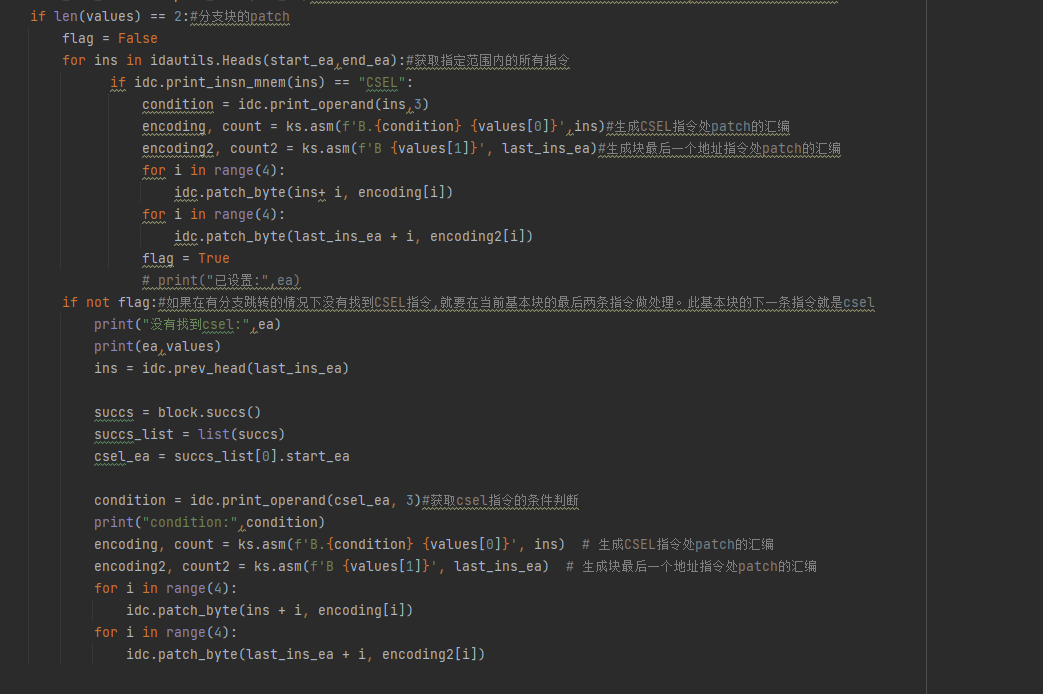
重建真实块之间的控制流反混淆的第三步,重建真实块之间的控制流。用idapython处理 重建控制流主要对两种方式进行处理 1.带csel指令的分支跳转 2.无分支跳转 完整代码脚本里写好了相关注释,这里直接贴代码 - from collections import deque
-
- import ida_funcs
- import idaapi
- import idautils
- import idc
- import keystone
-
- #初始化Ks arm64架构的so,模式:小端序
- ks = keystone.Ks(keystone.KS_ARCH_ARM64, keystone.KS_MODE_LITTLE_ENDIAN)
- def patch_ins_to_nop(ins):
- size = idc.get_item_size(ins)
- for i in range(size):
- idc.patch_byte(ins + i,0x90)
-
- def get_block_by_address(ea):
- func = idaapi.get_func(ea)
- blocks = idaapi.FlowChart(func)
- for block in blocks:
- if block.start_ea <= ea < block.end_ea:
- return block
- return None
-
-
-
- def patch_branch(patch_list):
-
- for ea in patch_list:
- values = patch_list[ea]
- if len(values) == 0:#如果后继块为0,基本都是return块,不需要patch,直接跳过
- continue
- block = get_block_by_address(int(ea, 16))
- start_ea = block.start_ea
- end_ea = block.end_ea
- last_ins_ea = idc.prev_head(end_ea)#因为block.end_ea获取的地址是块最后一个地址的下一个地址,所以需要向上取一个地址
- if len(values) == 2:#分支块的patch
- flag = False
- for ins in idautils.Heads(start_ea,end_ea):#获取指定范围内的所有指令
- if idc.print_insn_mnem(ins) == "CSEL":
- condition = idc.print_operand(ins,3)
- encoding, count = ks.asm(f'B.{condition} {values[0]}',ins)#生成CSEL指令处patch的汇编
- encoding2, count2 = ks.asm(f'B {values[1]}', last_ins_ea)#生成块最后一个地址指令处patch的汇编
- for i in range(4):
- idc.patch_byte(ins+ i, encoding[i])
- for i in range(4):
- idc.patch_byte(last_ins_ea + i, encoding2[i])
- flag = True
- if not flag:#如果在有分支跳转的情况下没有找到CSEL指令,就要在当前基本块的最后两条指令做处理。此基本块的下一条指令就是csel
- ins = idc.prev_head(last_ins_ea)
- succs = block.succs()
- succs_list = list(succs)
- csel_ea = succs_list[0].start_ea
- condition = idc.print_operand(csel_ea, 3)#获取csel指令的条件判断
- encoding, count = ks.asm(f'B.{condition} {values[0]}', ins) # 生成CSEL指令处patch的汇编
- encoding2, count2 = ks.asm(f'B {values[1]}', last_ins_ea) # 生成块最后一个地址指令处patch的汇编
- try:
- for i in range(4):
- idc.patch_byte(ins + i, encoding[i])
- for i in range(4):
- idc.patch_byte(last_ins_ea + i, encoding2[i])
- except :
- print("except")
-
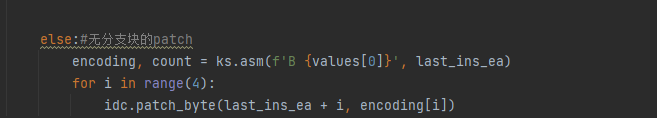
- else:#无分支块的patch
- encoding, count = ks.asm(f'B {values[0]}', last_ins_ea)
- for i in range(4):
- idc.patch_byte(last_ins_ea + i, encoding[i])
- print("pach over!!!")
-
- def find_all_useless_block(func_ea,real_blocks):
- blocks = idaapi.FlowChart(idaapi.get_func(func_ea))
- local_real_blocks = real_blocks.copy()
- useless_blocks = []
- ret_block_addr = local_real_blocks[len(local_real_blocks)-1]
- queue = deque()
- ret_block = get_block_by_address(ret_block_addr)
- queue.append(ret_block)
- while len(queue) > 0:#处理ret块相关的后继块
- cur_block= queue.popleft()
- queue.extend(succ for succ in cur_block.succs())
- ret_flag = False
- for succ in cur_block.succs():
- local_real_blocks.append(succ.start_ea)
- end_ea = succ.end_ea
- last_ins_ea = idc.prev_head(end_ea)
- mnem = idc.print_insn_mnem(last_ins_ea)
- if mnem == "RET":
- ret_flag = True
- if ret_flag:
- break
- # local_real_blocks.extend(succ.start_ea for succ in cur_block.succs())
- for block in blocks:
- start_ea = block.start_ea
- if start_ea not in local_real_blocks:
- useless_blocks.append(start_ea)
- print("所有的无用块:",[hex(b)for b in useless_blocks])
- return useless_blocks
-
- def patch_useless_blocks(func_ea,real_blocks):
- useless_blocks = find_all_useless_block(func_ea, real_blocks)
- # print(useless_blocks)
- for useless_block_addr in useless_blocks:
- block = get_block_by_address(useless_block_addr)
- start_ea = block.start_ea
- end_ea = block.end_ea
-
- insns = idautils.Heads(start_ea, end_ea)
- for ins in insns:
- patch_ins_to_nop(ins)
- print("无用块nop完成")
-
- patch_list = {'0x41d08': ['0x4221c'], '0x41da0': ['0x421c4', '0x42258'], '0x41e14': ['0x41fac'], '0x41e70': ['0x4213c'], '0x41f0c': ['0x42a80', '0x4200c'], '0x41f64': ['0x42ab0'], '0x41fac': ['0x42a80', '0x421d8'], '0x4200c': ['0x42a90'], '0x42058': ['0x41f64', '0x42ab0'], '0x420b4': ['0x41e70', '0x42208'], '0x420fc': ['0x42ab0', '0x421f0'], '0x4212c': ['0x42a68'], '0x4213c': ['0x4212c', '0x42ab0'], '0x42154': ['0x420b4'], '0x421b0': ['0x41fac'], '0x421c4': ['0x41f0c'], '0x421d8': ['0x42258', '0x42ab0'], '0x421f0': ['0x42ab0', '0x4223c'], '0x42208': ['0x4213c'], '0x4221c': ['0x42154', '0x4212c'], '0x4223c': ['0x41da0'], '0x42a48': ['0x42058'], '0x42a68': ['0x420fc', '0x42ab0'], '0x42a80': ['0x421d8'], '0x42a90': ['0x421b0', '0x41e14'], '0x42258': ['0x42a1c'], '0x422f8': ['0x42a48'], '0x42368': ['0x4266c'], '0x423dc': ['0x42368'], '0x42454': ['0x429d8', '0x426c8'], '0x424b0': ['0x42570', '0x42860'], '0x42518': ['0x42454'], '0x42570': ['0x42a04'], '0x425b8': ['0x428e4'], '0x4262c': ['0x429d8'], '0x4266c': ['0x42930', '0x428a8'], '0x426c8': ['0x42a2c'], '0x42718': ['0x428c0'], '0x42794': ['0x428a8', '0x42718'], '0x427d8': ['0x42918', '0x422f8'], '0x42808': ['0x427d8', '0x423dc'], '0x42860': ['0x42870'], '0x42870': ['0x42808', '0x42a48'], '0x428a8': ['0x427d8'], '0x428c0': ['0x4266c'], '0x428e4': ['0x42958', '0x42808'], '0x42918': ['0x429e8'], '0x42930': ['0x42794'], '0x42958': ['0x424b0'], '0x4299c': ['0x425b8'], '0x429bc': ['0x4299c'], '0x429d8': ['0x42a48'], '0x429e8': ['0x42518'], '0x42a04': ['0x42860'], '0x42a1c': ['0x429bc'], '0x42a2c': ['0x4262c', '0x429d8'], '0x42ab0': []}
- patch_branch(patch_list)
-
-
- # func_ea =0x41D08
- # real_blocks = [269576, 269728, 269844, 269936, 270092, 270180, 270252, 270348, 270424, 270516, 270588, 270636, 270652, 270676, 270768, 270788, 270808, 270832, 270856, 270876, 270908, 272968, 273000, 273024, 273040, 270936, 271096, 271208, 271324, 271444, 271536, 271640, 271728, 271800, 271916, 271980, 272072, 272152, 272276, 272344, 272392, 272480, 272496, 272552, 272576, 272612, 272664, 272688, 272728, 272796, 272828, 272856, 272872, 272900, 272924, 272940, 273072]
- # patch_useless_blocks(func_ea,real_blocks)
- # ida_funcs.reanalyze_function(ida_funcs.get_func(func_ea))#刷新函数控制流图
- # print("控制流图已刷新")
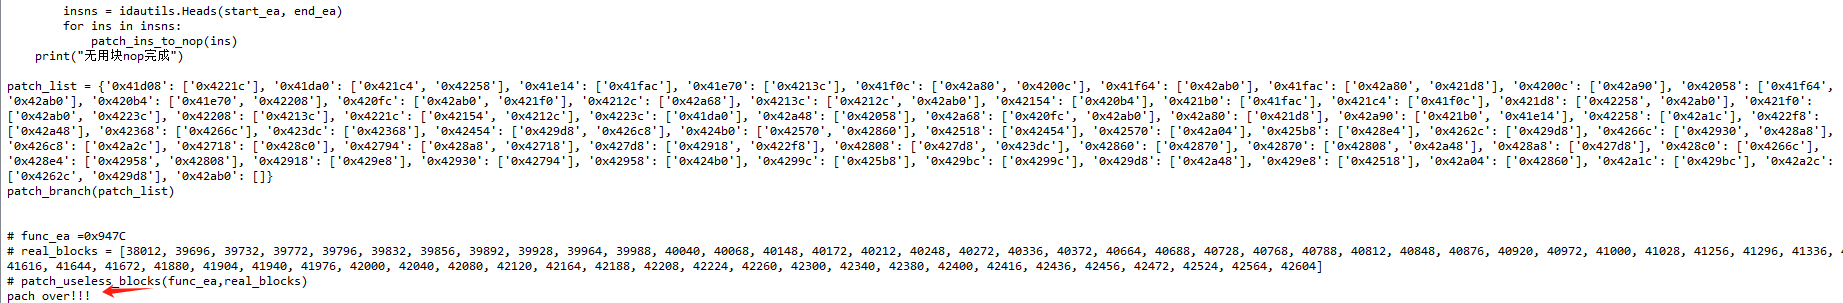
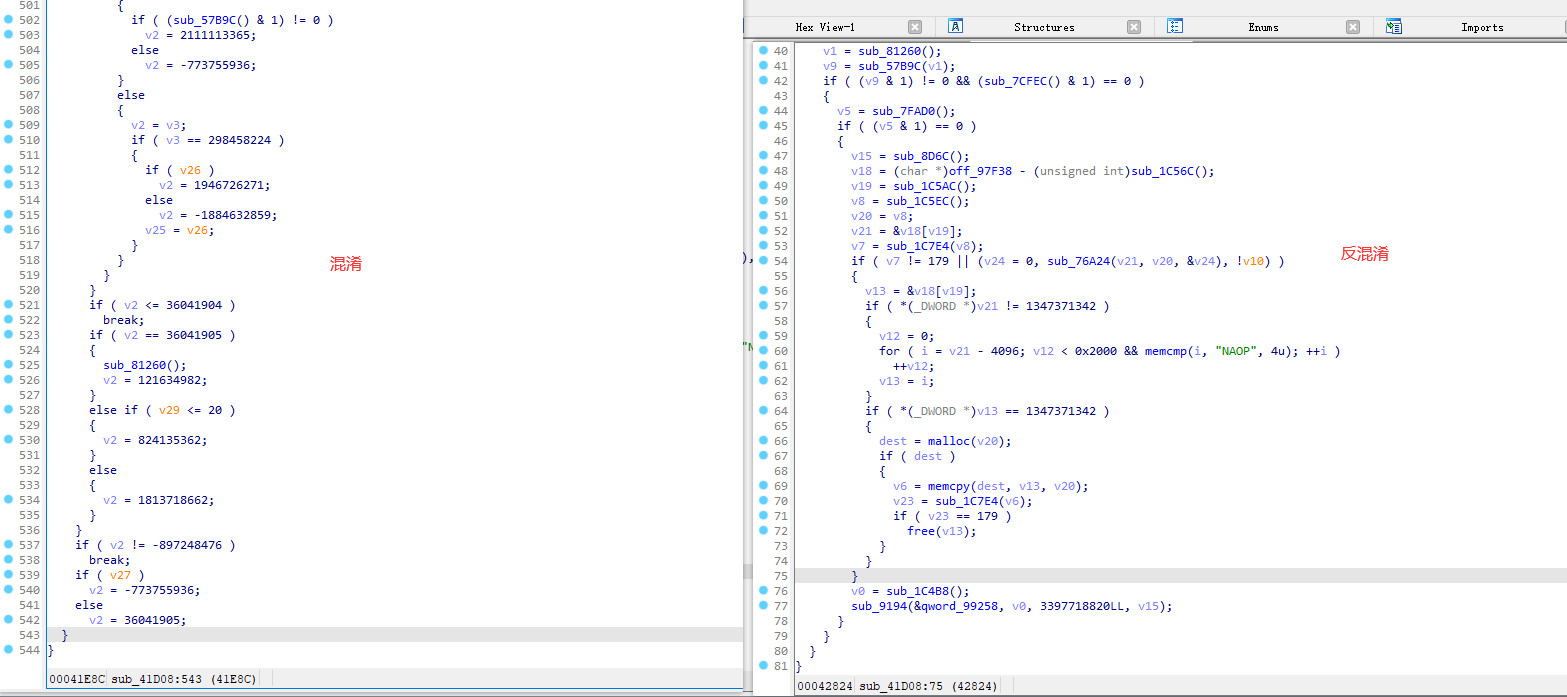
查看重建结果,可以看到已经反混淆成功了
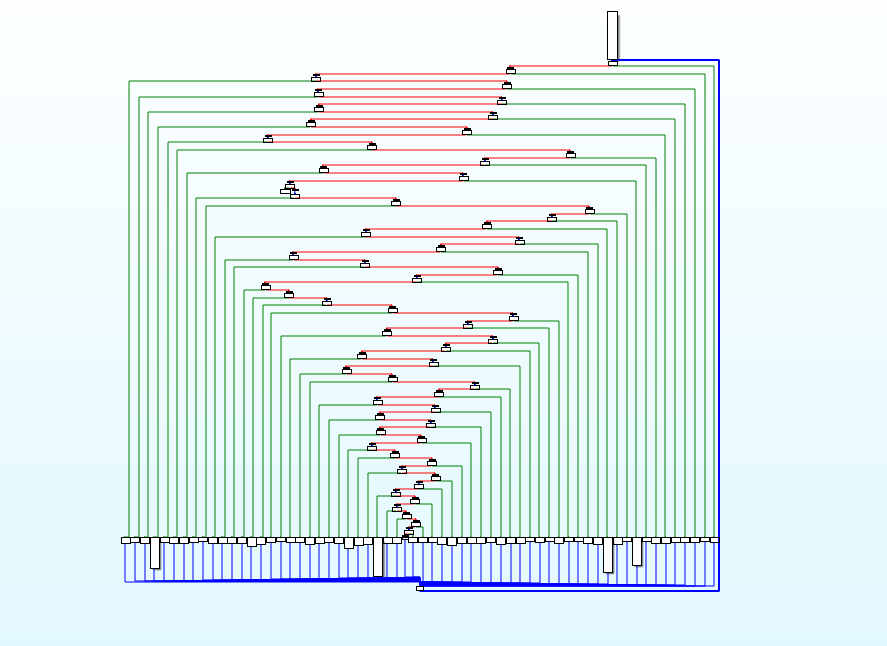
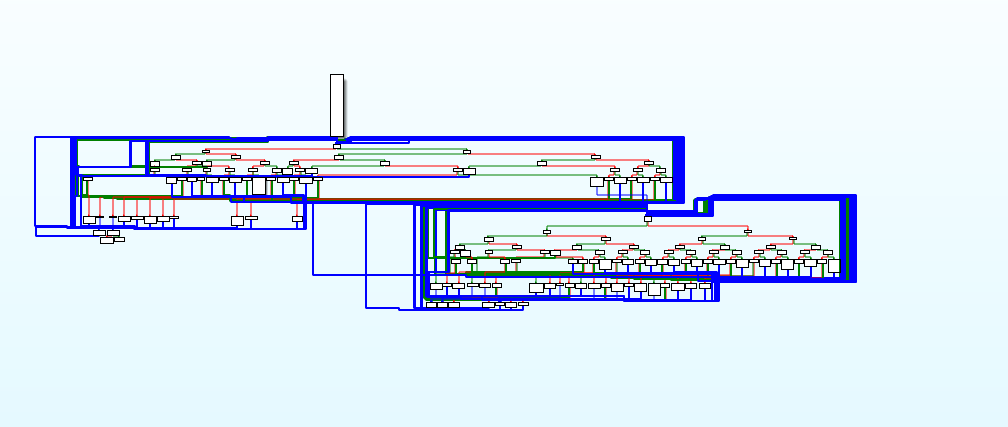
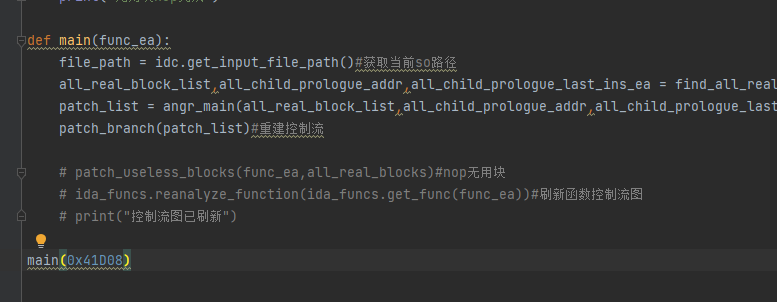
针对上述的脚本最后也是归纳到一起了,内容较多,就不贴代码了,脚本文件会放置在github地址下载 使用的时候只需要提供函数地址即可 其他案例1.cfg图
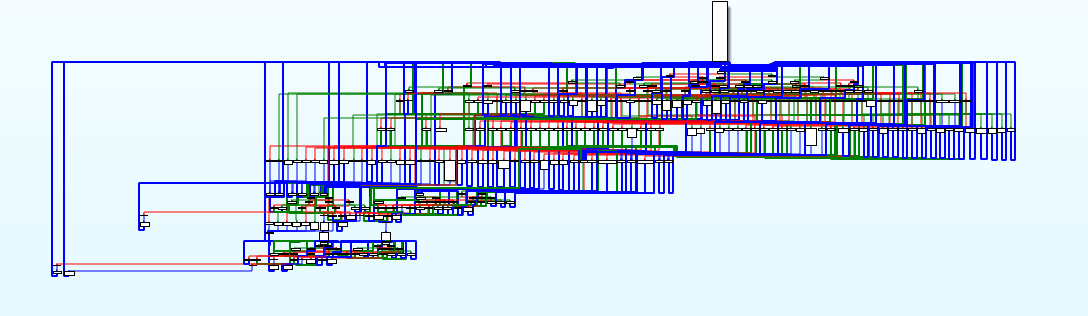
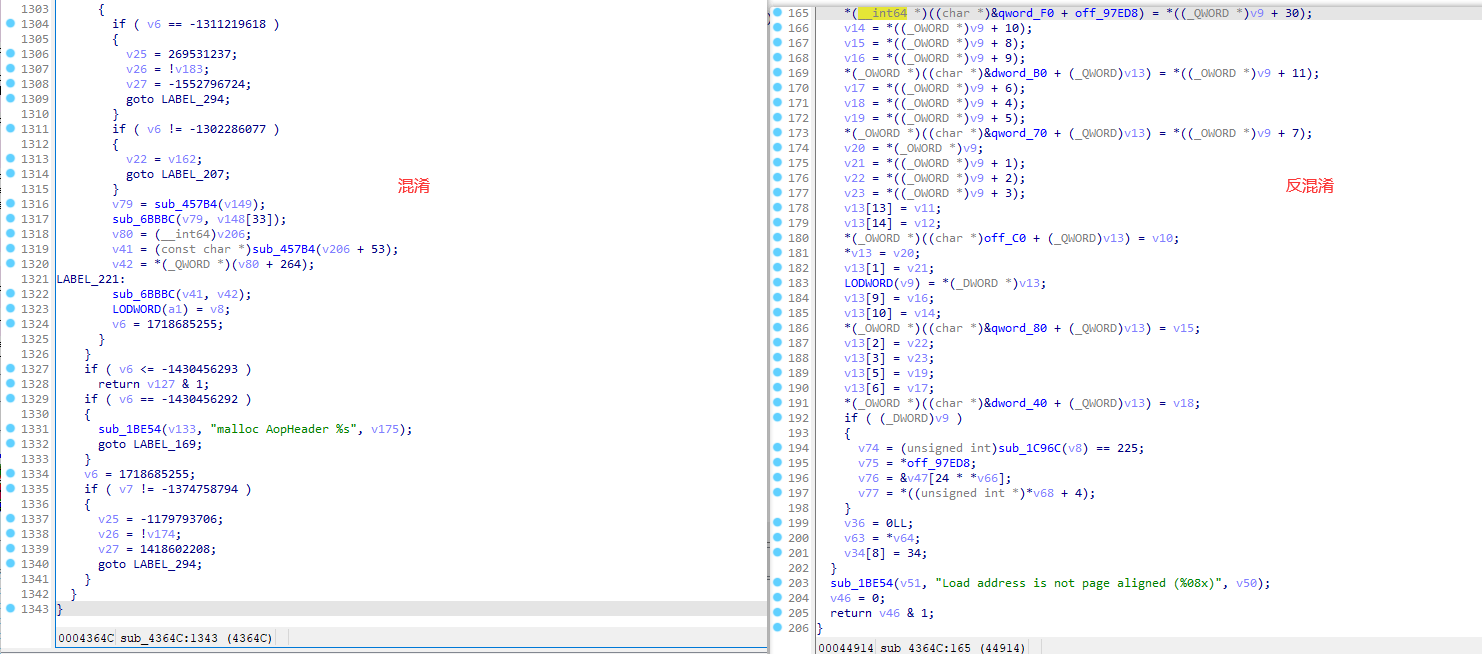
2.cfg图
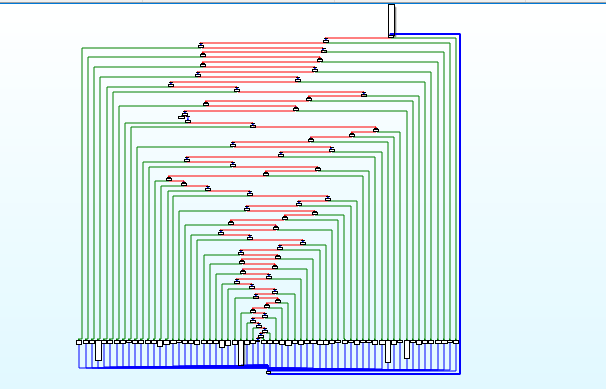
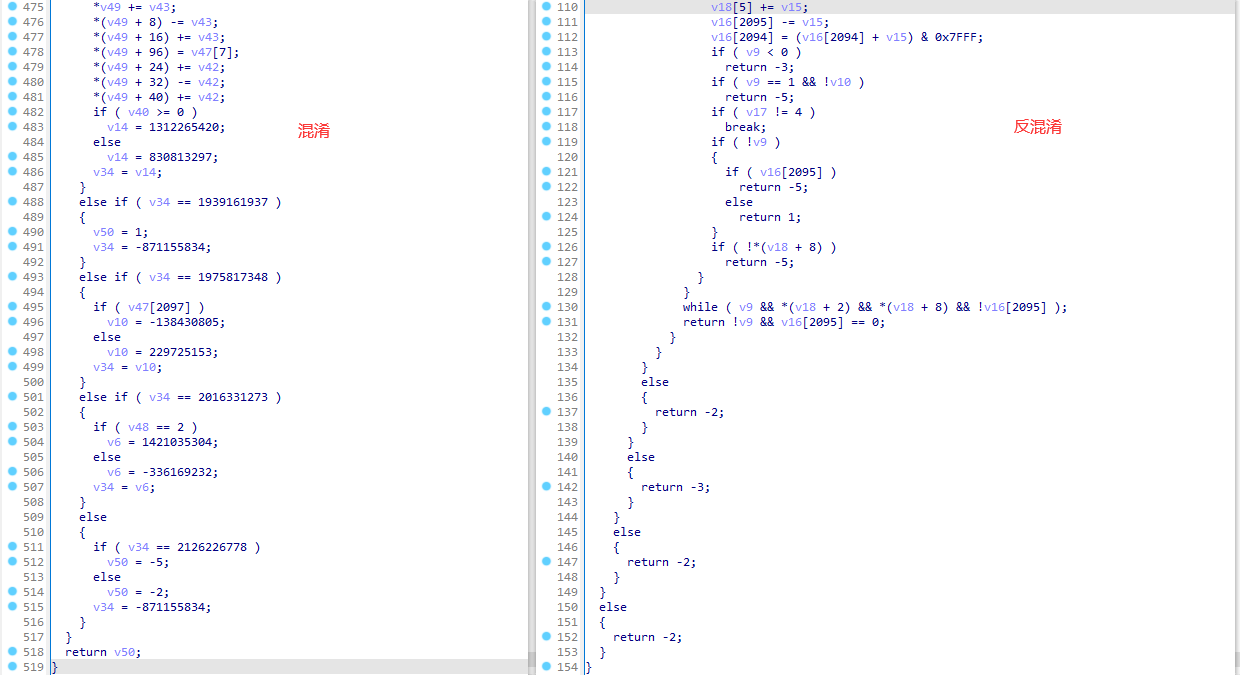
结尾ollvm-fla的混淆围绕三大步骤展开可以实现反混淆,脚本不是全部通用,如果遇到混淆程度非常复杂的,还得需要针对性去完善相关功能。
|


 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜